Composer des états avec des étiquettes exactes : des données d'entraînement sans une seule image client
Pour entraîner un modèle à vérifier l'état d'un entrepôt, nous collons les états dans de vraies images, pour que chaque exemple vienne avec une vérité connue par construction.
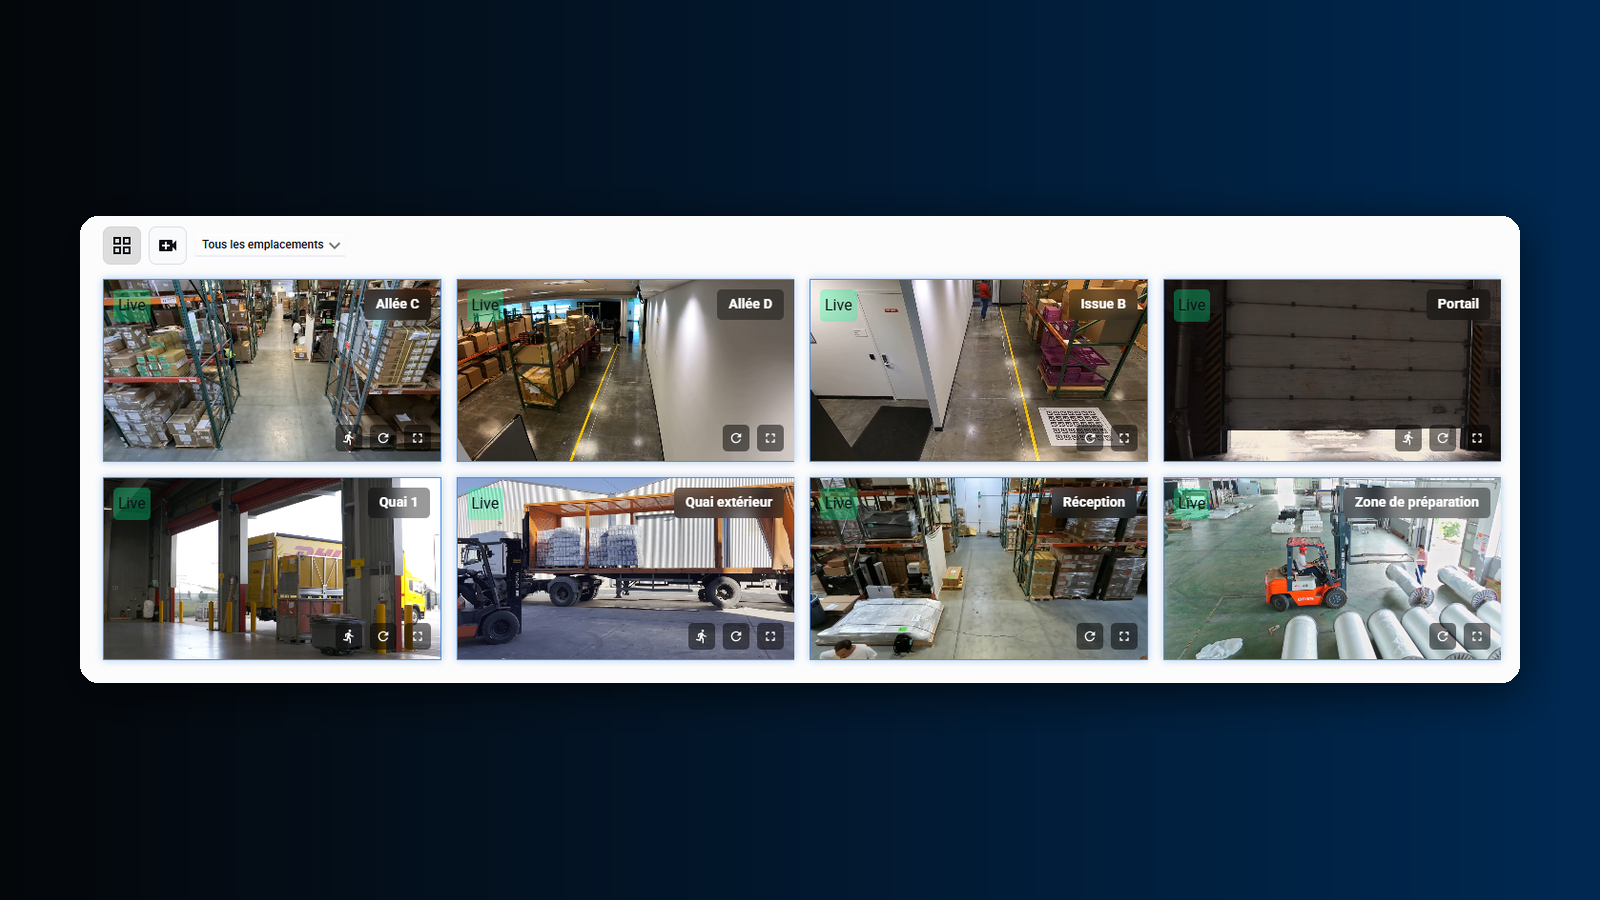
Un modèle qui vérifie des états sur des caméras fixes a besoin d’exemples de ces états : une issue obstruée, une allée coupe-feu rétrécie, des combustibles à côté d’un chargeur. Personne n’en mettra dix mille en scène sur un site en activité, et les images des clients ne sont pas des données d’entraînement. Notre démonstration colle déjà une palette dans de vraies images d’entrepôt. Fait systématiquement, avec des masques, de la géométrie et un contrôle des artefacts, cela devient un moteur de données dont les étiquettes sont exactes parce qu’elles ont été construites. Ce billet décrit le moteur, la raison pour laquelle les étiquettes exactes comptent, et la principale façon dont il pourrait nous tromper.1
Le principe
Partir d’une vraie image d’une caméra fixe où l’état est faux : l’issue est dégagée. Y composer l’état : une palette, un roll, une pile de cartons, pris dans une bibliothèque d’objets segmentés. Le moteur sait tout de ce qu’il a fait, donc chaque exemple porte une vérité que personne n’a eu à annoter :
- l’état (obstrué ou non) et la clause sous laquelle il tient ;
- le masque de l’objet, au pixel ;
- la zone, dans les coordonnées de la caméra ;
- pour les séquences, le moment où l’état apparaît et celui où il disparaît ;
- l’image intacte, qui est un négatif difficile gratuit.
Les paires contrefactuelles sortent aussi par construction : la même image avec la palette placée juste hors de la zone, ou posée sur le rack pour qu’elle ne touche plus le sol, donne l’item sur lequel « seulement si elle touche le sol » renverse la réponse.
Les composants
| Étape | Ce qu’elle fait |
|---|---|
| Plan du sol | Estimé par caméra à partir de quatre clics ou de la calibration SmartSpaces |
| Échelle | À partir du plan du sol, pour qu’une palette au fond ait la bonne taille |
| Ombre | Une ombre portée selon la lumière dominante de la scène |
| Occlusion | Ordre déduit des masques existants : un chariot devant cache l’objet collé |
| Couleur et bruit | Alignés sur l’image |
| Conditions | Augmentation : jour, infrarouge de nuit, niveau de compression, pluie sur le quai |
| Temps | Composition temporelle sur des images à quelques minutes d’écart : apparition, persistance, levée |
Pourquoi les étiquettes exactes comptent
L’affinage supervisé tolère un peu de bruit d’étiquetage. L’affinage par renforcement avec récompenses vérifiables, non : la récompense doit être calculée à partir d’une vérité que le modèle ne peut pas contester. « Le verdict correspond-il à l’état, les points tombent-ils dans le masque, la description mentionne-t-elle le bon objet et rien d’autre » ne sont des questions vérifiables que si l’état, le masque et l’objet sont connus exactement. L’annotation humaine de vidéosurveillance à ce volume serait lente, coûteuse et, sur des objets de trente pixels, pas exacte. La construction l’est.
Le risque principal : apprendre le collage
Un modèle entraîné sur des positifs composés peut apprendre « il y a un objet collé ici » au lieu de « l’issue est obstruée ». Il aurait de bons scores sur des items de test composés et échouerait sur la première vraie palette. C’est le risque qui décide si le moteur est utile, donc il reçoit plusieurs contrôles, tous mesurés :
- le contrôle des artefacts dans le compositeur : le même ré-encodage JPEG appliqué à toute l’image, pas de bords nets, un mélange randomisé ;
- un détecteur d’artefacts adversarial, entraîné à distinguer collé de réel, qui doit être au niveau du hasard sur le jeu d’entraînement ; les collages qu’il détecte sont rejetés ;
- au moins 20 % des positifs sont réels : mis en scène sur le banc d’essai, filmés par de vraies caméras, plus tard issus des pilotes ;
- le jeu de test caché ne contient que de vrais positifs, pour que tout écart entre exactitude sur composé et sur réel soit visible, et non noyé dans une moyenne.
L’hypothèse sur laquelle nous nous engageons est H5 : un modèle entraîné uniquement sur des positifs composés, testé sur de vrais positifs mis en scène, doit perdre moins de 5 points d’exactitude équilibrée.1 S’il en perd plus, c’est le moteur qu’on améliore avant le modèle.
D’où viennent les objets
SA-1B et SA-V fournissent une bibliothèque d’objets segmentés et de masques vidéo à composer ; la licence des produits qui en dérivent est à vérifier avant toute livraison.2 COCO, LVIS, POPE et RefCOCO ne servent pas du tout à l’entraînement : les encodeurs visuels des modèles candidats en ont déjà vu bien plus. Ils servent de tests de régression dans la porte de publication, pour qu’un affinage ne perde pas l’ancrage général en apprenant les entrepôts.3
La vie privée, par construction aussi
Aucune image client n’est utilisée pour l’entraînement. Les images de base sont publiques (SmartSpaces) ou mises en scène sur notre propre banc. Les images de pilotes ne quittent un site que sous accord de données, floutées, le CSE informé, et elles vont au test caché, pas à l’entraînement. Le modèle est entraîné sur des états, pas sur des personnes, et le moteur en fait une propriété des données plutôt qu’une promesse.
Le calcul
Le DGX Spark, avec 128 Go de mémoire unifiée, couvre la composition et l’augmentation, le détecteur d’artefacts, et l’affinage supervisé LoRA des modèles 4B et 9B ; les chiffres d’inférence mesurés dessus sont ceux du produit, puisque c’est la cible même de l’édition souveraine. Les entraînements GRPO, plusieurs GPU-jours chacun, vont sur les clusters de l’Inria. Rien dans le plan ne demande plus d’un nœud.1
Si vous avez un banc d’essai, quelques caméras et la patience de mettre en scène une issue obstruée vingt fois sous des lumières différentes, vous pouvez apporter de vrais positifs au test caché. C’est la partie qu’aucun moteur ne remplace.
Sources
- Camly AI, Beating frontier models with a small VLM: research plan, octobre 2026.
- Meta AI, Segment Anything 1 Billion (SA-1B) et SA-V. ai.meta.com
- COCO, Common Objects in Context. cocodataset.org